Détection multicatégorie
E-mails, téléphones, cartes (contrôle de Luhn), adresses IP, IBAN et comptes bancaires, mots de passe, clés et JWT, adresses postales, dates de naissance, pièces d'identité, dictionnaire personnalisé et noms en contexte.
Chargement de Veilforge…
PARE-FEU DE CONFIDENTIALITÉ POUR LLM
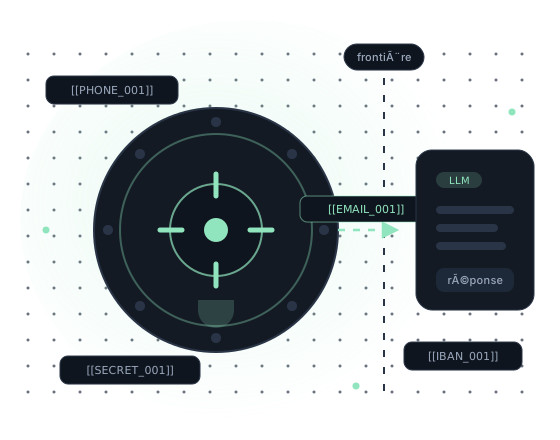
Veilforge détecte les données sensibles dans vos prompts, les remplace par des jetons réversibles, puis vous restitue la réponse de l'original. Les valeurs brutes restent sur votre machine.
Modèles et fournisseurs compatibles
DÉMONSTRATION
Texte 100 % fictif. L'analyse s'exécute sur votre instance locale : aucun appel n'est envoyé à un modèle.
Données fictives destinées à la démonstration. Ctrl+Entrée pour lancer.
 En attente de lancement
Les données détectées apparaîtront ici sous forme de jetons réversibles.
La réponse revient chargée de jetons : Veilforge rétablit les valeurs d'origine, dans la même session.
ARCHITECTURE
Seul du contenu tokenisé franchit la frontière vers le fournisseur.
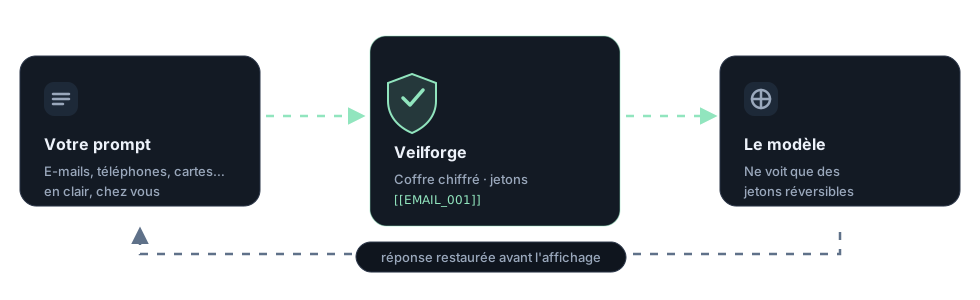
Votre prompt part vers Veilforge, jamais directement vers le modèle.
E-mails, téléphones, cartes, secrets… deviennent [[EMAIL_001]], chiffrés dans un coffre de session.
La réponse revient avec les jetons : Veilforge restaure les valeurs d'origine avant de vous la rendre.
client → détecteur / coffre chiffré → fournisseur→fournisseur → coffre → client
CAPACITÉS
E-mails, téléphones, cartes (contrôle de Luhn), adresses IP, IBAN et comptes bancaires, mots de passe, clés et JWT, adresses postales, dates de naissance, pièces d'identité, dictionnaire personnalisé et noms en contexte.
Une même valeur reçoit toujours le même jeton dans une session, pour garder le contexte cohérent. Les correspondances sont chiffrées avec Fernet.
Pointez votre client existant sur /v1 : chat completions, y compris le streaming SSE démasqué à la volée.
SQLite local chiffré, audit limité aux catégories, comptages et empreintes. Rétention et purge automatiques configurables.
Les formes de contenu non prises en charge et les pannes amont sont refusées plutôt que risquées en clair. Le diagnostic est audité.
Indices de détection en anglais, français, malgache, allemand et espagnol, sur une base de règles locale et vérifiable.
La détection par règles est une base fiable, pas une garantie de conformité. Ajoutez un détecteur NER local (spaCy/Presidio) via Detector pour un rappel plus élevé.
INTÉGRATION
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8787/v1",
    api_key="local-dev-key",
)

client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user",
               "content": "Écris un mail à ana@example.com"}],
)
Le même client OpenAI, seul le modèle change : VEILFORGE_UPSTREAM_URL doit pointer vers un amont compatible (par ex. OpenRouter) qui sert ces modèles.
VEILFORGE_UPSTREAM_URL et VEILFORGE_UPSTREAM_API_KEY orientent la passerelle vers votre fournisseur.
Sans fournisseur, la passerelle renvoie un écho de développement, jamais présenté comme une réponse de modèle.
La démonstration fonctionne sans fournisseur, sans clé et sans envoi réseau vers un modèle.